こんにちは!iimonでエンジニアをしている なかむ です。 普段は主に「入力速いもん」の拡張機能を開発しています!
今回は前回の「Claude Code でバグ修正をどこまで委任できるか試してみる 計画編」の続き、実践編です。
気づけばもう8月下旬ですね。前回ブログを書いてから早くも3ヶ月近くが経ちました。この間に新しいモデルが出たり機能が増えたりと、AI周りの進歩には目覚ましいものがあります。
前回は Claude Code Routines でどこまでAIに技術負債の修正を任せられるか、という計画を書きました。既存Issueに難易度ラベルを付ける評価Skillを作り、easyラベルのものから修正Skillに流し、最終的にRoutine化する、という3段構えです。
計画から変えた点が2つあります。
1つ目は、Routine ではなく Skill にしたことです。 Routine は時間をトリガーに自動実行されるため、チームがどれだけ消化できるかとは無関係にPRが積み上がります。レビュー待ちが溜まって形骸化する懸念があったので、「今やる」と決めたときに実行する Skill の方が、導入の様子を見ながら調整できると判断しました。
2つ目は、評価からやり直したことです。 既存のIssueを見に行ったところ、AIにとって文脈を解釈しやすい構造では起票されていませんでした。難易度ラベルを付ける以前に、Issueの分類そのものを見直す必要がありました。
AI DevEx Conference で受けた影響
7月に AI DevEx Conference に参加させていただきました。持ち帰るものが多かったです。AIによって開発のスピードが圧倒的に上がった一方で、フローの中に新しいボトルネックが生まれている、という話が全体の主軸でした。
ボトルネックとして挙げられていたものは、AIが出してきたもののレビューと、認知負債です。 認知負債とはざっくり言うと「AIが書いたコードが、自分が理解できないまま積み上がっていく状態」です。
この2つのボトルネックに対して、AIが動きやすい環境をどう仕組み化していったか、という各社の取り組みはどれも勉強になりました。
中でも評価層を作るときに参考にさせていただいたのが、kickflow の森本さんの「開発チームから『作業』を減らす仕組みのつくり方」です。
PRごとに変更の影響度を XS〜XL の5段階でAIがラベル付けし、XS・S はAIレビューとオートマージ、M以上は人がレビューする、というように対応を切り替える仕組みです。
スライドの内容は「できあがったPR」を評価してレビュー経路を分ける、いわば出口側の仕分けです。私がやりたかったのは「着手前のIssue」を評価してAIに渡すかどうかを決める、入口側の仕分けでした。評価する対象もタイミングも違いますが、「規模で対応を切り替える」という考え方をそのまま入口に持ってこられると考え、評価軸の修正から着手しました。
評価層やり直しの話
もともと /tech-debt というSkillを作ってメンバーに配っていました。開発中に気づいた技術負債を忘れずに起票すること、だけを目的にしていたので、リファクタもバグもセキュリティリスクも同じラベルで積まれていました。
前回の記事の時点で Open なIssueは92件でしたが、今回見たら150件に増えていました。
増えた理由は、/tech-debt を作って「こういうSkillを作りました!」と共有したところ、メンバーが率先して使ってくれたからです。3ヶ月で60件近く積み上がったということは、開発中に気づいてはいたけれど書き出す余裕がなかった、ということだと思います。起票の仕組みを用意するだけでこれだけ出てくるというのは素直に嬉しい結果でした。
AIに動きやすい環境を提供するには、AIが判断しやすい環境を整えることが大事です。そこでまず、Issueの分類から手を付けました。
新しく作った /issue-create Skill で付けるGitHubラベルは3軸です。
- type ── Issueの種別。リファクタなのか、バグなのか、セキュリティリスクなのか
- effort ── 実装に入るまでに必要な判断の量。森本さんの影響度ラベルを、Issue側の見積もりに読み替えたもの。判断の量を主軸に置き、目安として工数(SP)を併記しています
- priority ── 放置したときの影響。effort と掛け合わせて、どのIssueから着手するのが一番効果的かを測る
詳しいラベル分類の説明は以下です。
ラベル一覧を見る
type ── 何の負債か
| ラベル | 定義 |
|---|---|
type: bug |
実害が確認できる欠陥。誤った値・誤判定・例外 |
type: bug-suspect |
欠陥の疑い。調査が成果物。完了時に type: bug へ昇格するかクローズする |
type: security |
セキュリティリスク。XSS・権限・秘密情報の露出 |
type: perf |
性能劣化・無駄な処理 |
type: refactor |
挙動を変えない構造改善(分割・責務分離・設計変更) |
type: chore |
機械的な整理(typo・リネーム・デッドコード削除・一括置換)。判断を要さない |
type: test |
成果物がテストコードそのもの(追加・修正・基盤整備) |
type: deps |
依存更新・ビルド・CI・lint / formatter 設定 |
type: docs |
ドキュメントのみの変更 |
type: spike |
調査・技術検証。結論を出すのが成果物で、実装は後続 Issue に分ける |
effort ── 実装までの判断の量
| ラベル | 規模 | 定義 | 目安SP |
|---|---|---|---|
effort: XS |
極小 | 判断ゼロ。本文の修正案をそのまま適用できる | 0.5〜1 |
effort: S |
小 | 期待値の確認が1箇所必要。1メソッド修正+テスト | 2〜3 |
effort: M |
中 | 設計の選択肢が複数ある。1モジュール内に収まる | 5 |
effort: L |
大 | 複数モジュールに波及。影響調査が必要 | 8〜13 |
effort: XL |
特大 | 1つの PR で完了条件を表現できない。着手前に子 Issue へ分割する | — |
effort: ❓ |
見積不能 | 対応方針が決まっておらず規模を判断できない。方針を決めてから見積もる | — |
priority ── 放置したときの影響
| ラベル | 区分 | 定義 |
|---|---|---|
priority: 💎💎💎💎💎 |
即対応検討 | 誤情報が顧客データとして外部に出て社内で気づけない、または悪用されうる |
priority: 💎💎💎💎 |
重要な改善 | 誤った値が出るが特定サイト・条件に限られる、または目視で気づける |
priority: 💎💎💎 |
計画的に対応 | データは正しいが手戻りが出る。または開発速度・将来のバグに測れる影響がある |
priority: 💎💎 |
余裕があれば | やることは決まっていて、やれば終わる。命名・体裁・可読性の範囲 |
priority: 💎 |
保留 | 直さなくても誰も困らない。放置しても劣化しない。棚卸しで閉じる候補 |
priority: ❓ |
判定不能 | スコープが未定義で順位を付けられない。何をどこまでやるかを本文に書いてから判定する |
現在OpenなIssue 150件をAIに分類させた結果が以下です。なお、完全にAI任せの分類ではなく、途中まで人が付けていた重要度などのステータスを入力として渡した上でラベル付けさせています。
| effort | 件数 | 割合 |
|---|---|---|
| XS | 34 | 23% |
| S | 49 | 33% |
| M | 33 | 22% |
| L | 9 | 6% |
| XL | 8 | 5% |
| 未判定 | 17 | 11% |
XS と S を合わせて83件、全体の55%でした。判断がほとんど要らない修正が半分以上あるということなので、AIに渡す候補がこれだけある、という見立てが立ちました。
個人で試した設計と実装
まだこれはチームで運用できていないので、個人で試してみた流れをお伝えさせていただきます。
設計するにあたって、2つの話を前提に置きました。
- 人間の脳は、複数のタスクを同時に捌くようにはできていない。アメリカ心理学会(APA)によると、実際に起きているのは「同時処理」ではなく「切り替え」で、切り替えのたびに生産性が削られる(研究では最大で作業時間の40%と推定される)
https://www.apa.org/topics/research/multitasking
- Claude Code の性能を活かすには、最高のプロンプトを用意するよりも、賢いモデルが思う存分働けるような環境を作り込むこと。Anthropic 自身が、セッションをまたいで安定して動かすには初期化エージェントと進捗ファイルといった「ハーネス」の設計が要る、と公式ブログで書いています
Effective harnesses for long-running agents \ Anthropic
ただ、続編では、ハーネスの要素はモデルの進化ですぐ陳腐化するので定期的に見直す価値があるという話も出ています。作って終わりにしないという意味で自戒になりました。
Harness design for long-running application development \ Anthropic
この2つを踏まえて、人が判断する局面を減らし、かつAIのための環境整備(巷でいうハーネスエンジニアリング)をすることにしました。
ハーネスエンジニアリング: AIモデル(頭脳)単体の性能に頼るのではなく、その周囲にルール、ツール連携、検証ループ、メモリ管理といった「外側の環境や制御の仕組み(ハーネス)」を設計し、AIエージェントを実務で安定して安全に動かすための技術やアプローチ
(AIDD「ハーネスエンジニアリングとは」 より)
気をつけたこと
人が判断する局面を減らすといっても、認知負債を放置するわけにはいきません。技術負債同様にいつかそのツケを支払うときが来ます。そこで、最初に「理解」のフェーズを挟むことにしました。ここはエンジニア自身で修正する対象とその理由を話させるようにしました。逆に、commit や push、PR作成のように「わざわざ手を動かすのが面倒なだけ」のものは自動化します。理解と判断は人間に残し、作業だけをAIに渡す、という線引きです。
実装したこと
具体的に取り組んだハーネスは3つです。
- settings.json の役割を「一律禁止」から「取り返しのつかないものだけ禁止」に変更
- 条件付きで判断すべきものを hooks へ移動
- 一連のフローをまとめた Skill を作成
なぜ移したのか
これまでは rm、push、commit、PR作成をすべて settings.json の deny に入れていました。安全ではありますが、毎回自分で実行することになり、AIに任せる意味が薄くなっていました。
settings.json に deny と書かれたコマンドは、たとえ dangerously-skip-permissions モードでも、Skill の allowed-tools で許可されていても、hooks の PreToolUse hook が「許可する」と返しても、settings.json の deny が勝ちます。逆方向、つまり hook が「拒否する」と返した場合は権限モードに関係なくブロックされます。締める方向にだけ効く、と覚えておくと分かりやすいです。
そのため、settings.json には取り返しのつかない、一律で設定できるコマンドだけ記載するようにしました(.env を読むなどは引き続き deny に入ります)。
ポイントは、allow にも書かないことです。Claude Code の許可ルールは deny → ask → allow の順に評価され、最初に一致したものが有効になります。どのリストにも書かなければ、既定は「毎回聞かれる」になります(ls や cat などの組み込みの読み取り専用コマンド群は例外で、聞かれずに実行されます)。
Configure permissions - Claude Code Docs
そのうえで hook の PreToolUse(ツールを実行する前に発火)で、安全な条件をすべて満たしたときだけ許可を返すようにしました。条件を外れたときは hook が何も返さないので、通常どおり聞かれる状態に戻ります。禁止しているわけではなく、判断を人に戻しているだけ、という状態です。
(matcher に Read や Write も入れているのは、同じスクリプトで秘密情報を含むファイルへのアクセスもまとめて見ているためです。)
保護ブランチへの push だけを止める PreToolUse hook(抜粋・そのままでは動きません)
$cmd $branch の取得と deny / allow 関数の定義は省略しています。
// settings.json から hook スクリプトを呼び出すところ

"hooks": {
        "PreToolUse": [
            {
                "matcher": "Bash|Read|Edit|Write|NotebookEdit",
                "hooks": [
                    {
                        "type": "command",
                        "command": "bash \"${CLAUDE_PROJECT_DIR}/.claude/hooks/forbidden-box.sh\"",
                        "timeout": 5
                    }
                ]
            }
        ],
...}
# --- 保護ブランチへの push / force push ---
if printf '%s' "$cmd" | grep -Eq '(^|[;&|(`])[[:space:]]*git([[:space:]]+-[^[:space:]]+)*[[:space:]]+push([[:space:]]|$)'; then
    if printf '%s' "$cmd" | grep -Eq '(^|[[:space:]])(-[[:alnum:]]*f[[:alnum:]]*|--force|--force-with-lease)([=[:space:]]|$)'; then
        deny "禁止の箱: force push はブロックされています(コマンド: ${cmd})。"
    fi
    if printf '%s' "$cmd" | grep -Eq '(^|[[:space:]:+/])(main|master|develop)([[:space:]]|$)'; then
        deny "禁止の箱: main / master / develop への push はブロックされています。PR 経由でマージしてください。"
    fi
    case "$branch" in
        main | master | develop)
            deny "禁止の箱: 現在 ${branch} ブランチにいるため git push をブロックしました。作業ブランチを切ってください。"
            ;;
    esac

    # ここまでの deny を全て通過した push のうち、作業ブランチからの単一コマンドだけ自動許可する。
    # 複合コマンドは push 以外の処理が同時に走るため対象外(判定できないものは確認へ回す)。
    case "$cmd" in
        *'&&'* | *'||'* | *';'* | *'|'* | *'$('* | *'`'* | *'>'* | *'<'*) ;;
        *)
            case "$branch" in
                feat/* | fix/* | test/* | feature/*)
                    allow "作業ブランチ(${branch})への push のため自動許可"
                    ;;
            esac
            ;;
    esac
fi
hooks にはもうひとつ、SessionEnd(セッション終了時に発火)でナレッジを追記させる役割も持たせています。せっかく/grill-meで得た情報が残らない、という状態を避けたくて入れました。追記先は .claude/rules/ 配下です。どのファイルに書くかの判断は、内容に応じて適切な場所へ記載してくれる /apply-contents という Skill に任せています。
Hooks reference - Claude Code Docs
許可コマンドを広く取った Skill の作成
それと、Issueを引数として渡したら一連のフローが行える Skill を作成してみました。
deny に書いていなくても、settings.jsonのどのリストにも書いていないコマンドは既定で毎回聞かれます。つまり settings.json を整理しただけでは、commit も push も PR作成も判断で止まったままです。
そこで、修正から PR作成までを一続きで回す /auto-fix-cycle を作り、この Skill の allowed-tools に commit・push・PR作成を明示的に書きました。「この流れの中でなら、この3つは聞かずに実行してよい」という許可の与え方です。Skill の外で単発に叩いたときは、これまでどおり聞かれます。
イメージするフローとしてはこんな感じです。
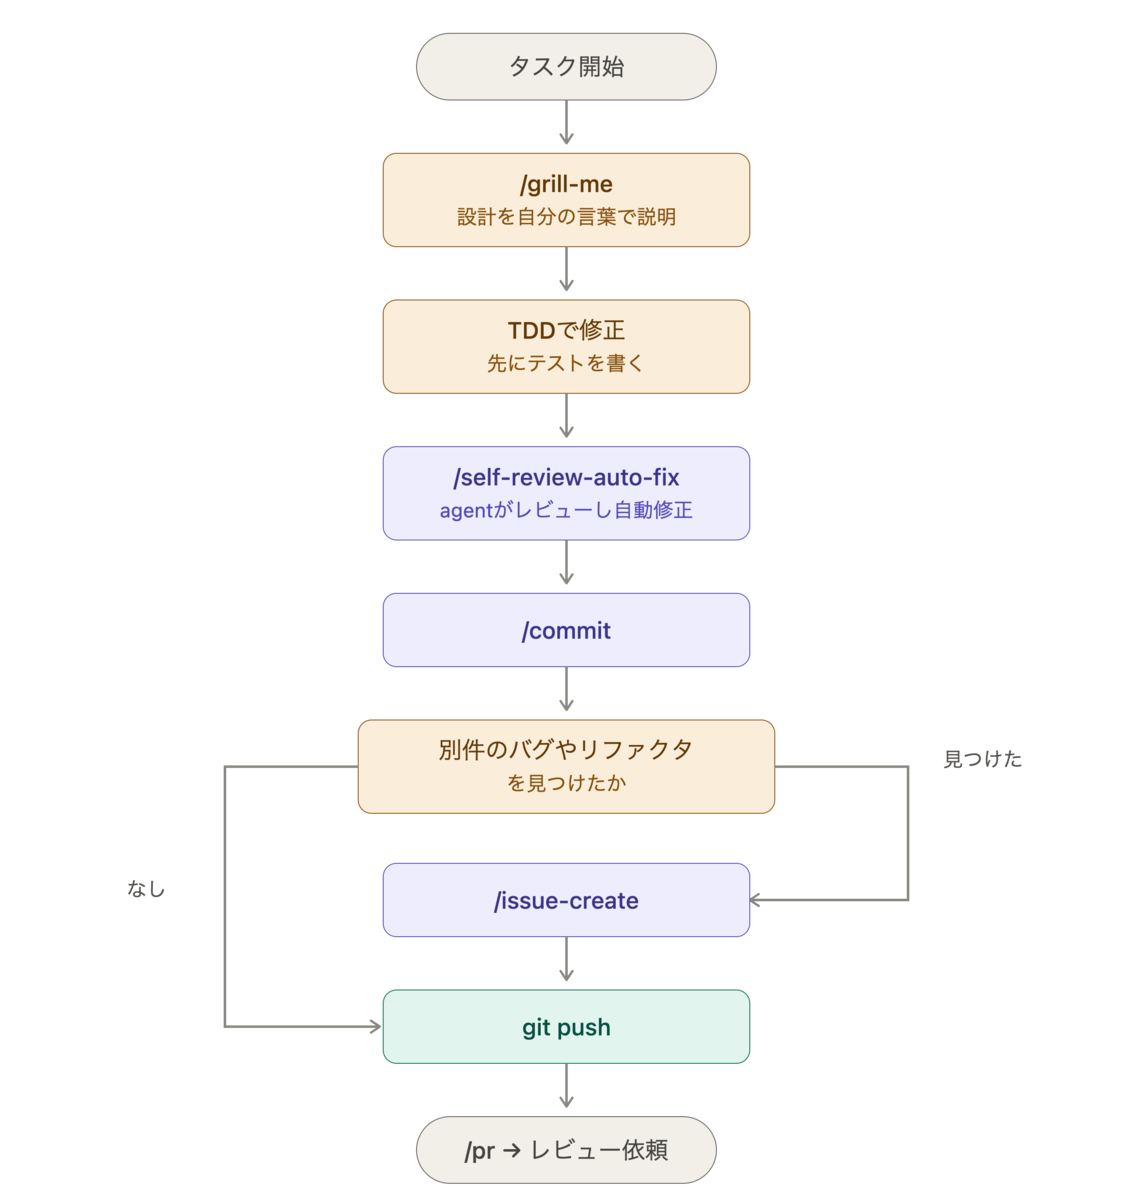
※ 色の付いた箱が人間の判断が入るところ
| ステップ | やること |
|---|---|
/grill-me |
修正対象と方針を説明できるか確認する。ここが理解のフェーズ |
| TDDで修正 | 失敗するテストを先に書いてから直す |
/self-review-auto-fix |
自社ルールを読み込んだ agent がレビューし、指摘を反映する |
/commit |
コミット |
/issue-create |
修正中に見つけたバグやリファクタ対象を起票する |
/pr |
PR作成 |
先頭の /grill-me は、作業に入る前にAIから設計の質問をしてもらう Skill です。もとは以下の方が公開されているもので、本家から少しカスタムして問題数を減らしました。設計判断が要る修正のたびに挟むものなので、質問が多いと結局やらなくなってしまうためです。逆に、判断ゼロのXSのような機械的な修正では発動させないようにしています。
GitHub - mattpocock/skills: Skills for Real Engineers. Straight from my .agents directory. · GitHub
数件試したところ、XS規模のIssueであれば1件あたり概ね5分程度でPR作成まで到達できるようになりました(XSでは /grill-me が発動しないため、この5分に理解フェーズの時間は含まれていません)。
ナレッジについては hooks の SessionEnd で溜まっていくようにしているので、回数を重ねるほど指示が減っていくことを期待しています。まだ数件なので、これがうまくいくかはこれから検証しようと思います。
本当は検証やレビューまでやりたかったのですが、締切の都合で間に合いませんでした。もし、この仕組みでIssue解消の一手になればまた検証編も書いてみようと思います。
まとめ
どんな技術もそうですが、使われて初めて効果を発揮します。/issue-create で起票が増えたのもニーズがあったからですが、それ以上に、使ってくれるメンバーがいたからです。チーム導入するにも、まだまだブラッシュアップが必要なので、少しずつ改善していければと思います。何かアドバイスやご意見がありましたら、教えていただけると嬉しいです!
AIによって働き方が変わる部分は確かにあります。ただ、AIが開発を担うようになって逆に人に求められることは「機嫌良くいること・好奇心を持ち続けること・健康でいること」だと t-wada さんもおっしゃっていました。
https://www.youtube.com/watch?v=BwqguC26MsY
実際、他部署の方と話すと、開発の中では拾えていなかったビジネスロジックやナレッジが見えてくることが少なくありません。巨大企業のAI活用のスピードに圧倒されたり、Anthropic のバージョンアップに翻弄されたりする日々ですが、身近な人とのコミュニケーションの価値がむしろ見えてきた、というのが今の実感です。
ここまでお読みいただきありがとうございました!
最後に
iimon は、他部署の方と週一でシャッフルランチに行けたり、技術のキャッチアップを応援してくれたりする風通しのいい環境です。この記事を読んで少しでも興味を持ってくださった方がいらっしゃいましたら、ぜひカジュアルにお話させていただきたいので、ご応募いただけると嬉しいです!
iimon採用サイト / Wantedly / Green
参考
- APA "Multitasking: Switching costs" — https://www.apa.org/topics/research/multitasking
- Anthropic "Effective harnesses for long-running agents" — https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- Anthropic "Harness design for long-running application development" — https://www.anthropic.com/engineering/harness-design-long-running-apps
- Claude Code Docs "Permissions" — https://code.claude.com/docs/en/permissions
- Claude Code Docs "Hooks reference" — https://code.claude.com/docs/en/hooks
Claude Rulesが無視される、後半で言うこと聞かない——コンテキストを立て直す3つのコマンド /btw・/rewind・/clear
CLAUDE.mdは書いても守られない——ルールが効かなくなる3つの理由と、22件の事故から学んだハーネスエンジニアリング
