こんにちは、エンジニアの須藤です。今回はAWSサミットに参加して、LLMアプリケーションでは評価が重要だという話があったので、LLM-as-a-Judgeについて整理してみることにしました。
実際のLLMアプリケーションの運用では、振る舞いがプロンプトの変更やモデルバージョンの変更で崩れたり、一度修正した内容が次のリリース時に壊れたり、仕様オーナーの判断が属人化してしまうということが起こり得ます。
判定にLLMを使ってみよう、と単純にjudgeを呼び出すだけでそれらが解決するわけではなく、どんな内容を、どんな単位で考え、人間の判断との一致を測るか、そして信頼性を維持しながらどこまで自動化してどう人間の確認を入れるかという部分が重要になるのかなと思います。
また整理することで評価結果の問題の切り分けが行える状態を目指します。
※ この記事ではLLM-as-a-Judgeの実装や精度検証については扱いません
※ 対象は本番化前に実行するoffline評価です。
- 何を材料にし、どの基準で判定し、結果をどう表現するかを決める
- 評価観点と判定単位を設計する
- 判定を収束させる
- judge判定の用途と、人間確認に戻す境界を決める
- 実運用に近づける評価フローを考える
- おわりに
何を材料にし、どの基準で判定し、結果をどう表現するかを決める
LLM-as-a-Judgeの背景
通常のプログラムのテストなら、入力に対する正解が一つに決まるという前提の上でassertEqual(f(x), 期待値)を書けば済みますが、翻訳や要約のような生成タスクでは、言い換えが複数あるため、出力が許容可能かを機械的に判定する基準を置きにくくなります。これはテストオラクル問題として扱われる難しさの一つです。
こうした背景から、機械翻訳ではBLEU、要約ではROUGEのように、参照回答との表層的な重なりを使う自動指標が広く使われてきました。
参照回答を準備でき、出力が一意に決まる状況では、表層一致で十分な場合もあります。一方で、生成結果が一意に決まらない場合、表層一致は正しい言い換えを落としたり、正しい語を含んでいれば誤情報を含んでいても通してしまったりします。
ここで必要になるのは、意味的な妥当性の判断です。これは人間が得意ですが、人間には処理速度・人件費・集中力や判断能力の継続性に限界があります。
そこで、LLMに判定を担わせるLLM-as-a-Judgeが使われます。
判定を任せられる理由
LLM自身が正しく生成できるとは限らないのに、信頼に値する判定ができるのかという違和感があるかもしれません。
ですが、生成と判定は別のタスクです。生成は広い出力空間の中から意味の通る出力を作る行為であるのに対し、判定は、材料・基準・結果表現を適切に設計できれば、より狭い出力空間に写像する問題として扱いやすくなります。
ただ、いくら扱いやすくできるとはいえ、正しいこととは別なので、judge自身も検証対象になります。
また、LLMとは切り離せない確率的で揺れうる性質を前提に、判定をどこまで収束させられるか、どの範囲なら信頼して使えるかを確認しながら設計する必要があります。
※ 意味的な妥当性以外の保証や判定は前回の記事(LLMが構造的な出力を行う方法を調べてみた)のように生成段階の保証を利用したり、assertEqualで済む場合もあります。
判定に必要なもの
まず評価に必要なものを段階的に整理してみると、大きく3段階に分けることができ、上位は下位の情報や判定可能な問いを含むと見ることができます。
| 段階 | 判定できる問いの例 | 必要な情報 |
|---|---|---|
| 単一の出力だけで判定 | 文体・禁止語・出力形式が条件を満たしているか | 出力と判断基準 |
| 入力を含む | 資料にない値を足していないか、問われた項目に正しく紐づけているか | 入力・出力・判断基準 |
| 状態再現まで必要 | 前の発話や画面状態を踏まえて仕様通りに振る舞っているか | 状態・入力・出力・判断基準 |
入力・出力、特に状態再現を前提に設計しておくと、広い判定に対応しやすくなることがわかります。
基準を定める
意味の妥当性判断における判定基準を書き出したものを採点表(rubric)といい、judgeに渡します。
まず注意したいのは、回答の質や良さといった、どの判定結果に写像するかの境界が曖昧な基準をそのままjudgeに渡すことです。このような基準では、どこを見てpass/failにするのかが曖昧になり、judgeの解釈が広がりやすくなります。その結果、判定根拠がブラックボックス化し、結果も安定しにくくなります。
逆に、基準がそれぞれyes/noで答えられる具体的な評価観点にすると安定しやすくなり、原因の切り分けもしやすくなります。
判定の粒度はそれにどんな情報を同居させるかという視点で見ることができ、ラベル付けや検証のコストを考えると、判定に対する改善アクションからみて必要十分な単位で分類を切るという判断も考えられます。
例えばgood/badで切ると、goodの中に「そのまま通してよいもの」と「通せるが改善したいもの」が混ざることがあります。この2つで対応方針が変わるなら分ける意味があります。一方で、分けても対応方針が変わらないなら、分類を増やしても運用上の価値は出にくくなります。
絶対的な判定が困難な好みやニュアンスのチューニングや言語化しにくい質の改善は合否線も引きにくいため、無理に定量化せず、今回の整理では別のフローで比較評価(pairwise)や人間レビューを通じた改善に回します。
また、情報不足などで判断不能になる場合は、合否や点数の尺度とは別にabstain(棄権)のような尺度外の処理種別としてもたせると切り分けやすくなります。
評価観点と判定単位を設計する
判定の材料と基準の設計とは別に、評価観点にどのような種類があるかを整理します。
観点の種類
評価観点は大きく2種類に分けることができ、1つは接地しているか・棄権が適切かのようにケースが変わっても同じ基準で測れる横断的な評価観点、もう1つは個別のシナリオが持つ固有のルールのように特定のケースの仕様にだけ紐づくケース固有の評価観点です。
また、ケースと評価観点は1対1とは限らず、同じケースが複数の評価観点でそれぞれ判定されるという多対多の関係になることもあります。
評価観点ごとに結果をケース横断で集計するとき、特に意味が出やすいのは横断的な評価観点の方です。
ケース固有の評価観点を無理に「仕様準拠」のような1つの観点名にまとめると、ケースごとに中身の違う判定を同じ単位で集計することになります。まとめた集計値は全体の傾向を監視する用途には使えますが、どこが壊れているかに気づくための指標としては粗すぎます。
判定に必要なもので見た情報の段階とも重なる話で、状態再現まで必要な仕様準拠はその状態自体がケース固有の設計であることが多く、横断的にはなりにくいです。集計値の大小より先に、そもそも異なる判定を同じ単位として集計してよいのかを問う必要があります。この記事では、こうして同じ単位として集計してよいと判断したまとまりを判定単位と呼びます。
判定を収束させる
judgeに自由に判断させるのではなく、同じ情報・同じ順序・同じ境界・同じ条件で判定させるように設計します。
判定の揺れを収束させる
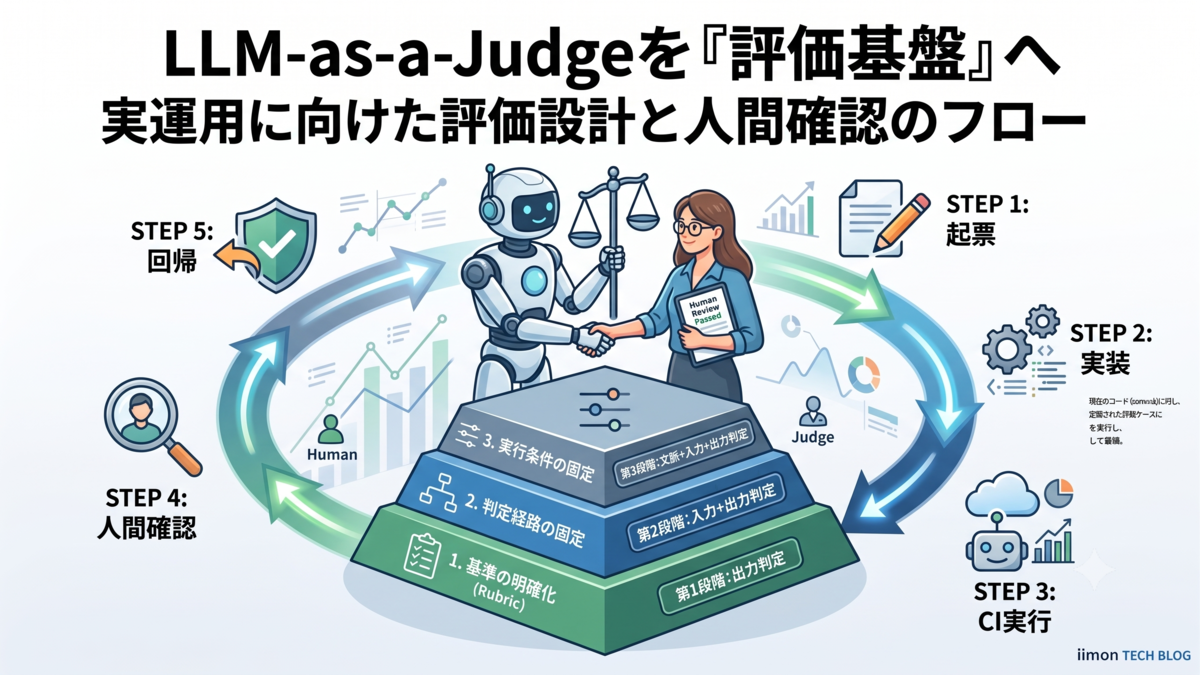
judgeもLLMである以上、誤るだけでなく同じ条件でも判定が揺れることがあります。手を入れる場所は基準の明確化・判定経路の固定・実行条件の固定の3つが考えられます。基準の明確化は何を満たせばpassかという条件の境界、判定経路の固定はどの情報をどの順で確認するかという確認経路の境界で、どちらも曖昧さを減らすための設計です。
- 基準の明確化
- rubricは、評価者に自由な解釈をさせるためでなく、判定の境界を共有するために書き、何を見て、どの条件を満たせなかったらfailにするのかが見える形にします。「同じ資料内にある別事業者の運賃を、問われた路線の根拠として使っていないか」のように条件を具体化するのは、この境界を見える形にする一つの例です
- 判定経路の固定
- 確認する順序・深さ・対象・条件——どの情報を確認してから、どの境界で切り、どの条件を満たしたらpass/failにするか——を先に具体的に固定します。判定理由を構造化してから最後に判定結果を出させるのは、この固定を実現する一手段にすぎません
- 実行条件の固定
- 温度・推論モード・モデルversion・prompt/rubricのversion・出力形式・retry設定を固定してバージョン管理し、変えたら再検証します。固定しないと「judgeが良くなった」のか「設定が変わっただけ」なのか切り分けられません
この3つは境界を明確にすることで揺れの発生自体を減らすアプローチです。ただ、効いているかどうかは、判定境界の差が出る評価ケースがないと確認できません。
評価ケースを設計する
基準と結果表現を決めたら、その判定境界を確認できる評価ケースを作ります。必要なのはただのデータセットではなく、判定境界や設計の差が実際に表れる評価ケースで、後から同じ条件で判断し直すための土台にもなります。評価ケースの設計で特に壊れやすいポイントは2つあるかなと思います。
一つは個別最適化です。データセット内の個別のケースに最適化されると、数字が実力を表さなくなります。固有名詞に依存した指示や特定のケースだけに効く条件分岐が増えていくという形で進みがちで、設計に使ったケースをそのまま検証に使うと、judgeやrubricがそのケースに最適化されて一致率が実力より高く出ます。
これは問題を「解けている」のではなく、そのケースの答えを「覚えている」だけの状態に近づいているということです。チューニングに使ったケースだけで実力を測っていないかには注意が必要です。
coding agentでrubricやプロンプトを自動改善するときも、同じ手元データセットに何度も当てて調整を繰り返すと、そのデータセットにだけ効く個別最適化が静かに進むことがあります。
もう一つは、判定境界の近くで評価できているかです。難しいケースを増やせばよいというわけではなく、改善すればfailがpassに変わるような判定境界の近くのケースが必要です。どんな設計でも結果が変わらないケースばかり集めても判定差が出ず、失敗モードも表に出ません。
統計的手法による安定化
ここまでは判定の揺れを設計で減らす話でしたが、それでも判定には確率的なばらつきが残ります。これを統計的に抑える手法として、複数judgeの投票、つまりjuryがあります。juryは境界を明確にする手法ではないため、まずは単一judgeと人手ラベルとの一致度を測り、必要なら単一judge側を改善した後に検討します。
異なる傾向を持つjudgeを組み合わせられる場合は、自分と似た出力を高く評価してしまう偏り(self-preference)のような系統誤差を弱められることがあります。
ただし、多数決で安定化が期待できるのはCondorcet(コンドルセ)の陪審定理が効く条件、つまり各judgeの誤りが十分に独立していて、二値判定における各judge単体の正解確率がランダムな判定よりも高い場合に限られます。逆に、個々のjudgeが人手ラベルよりも一貫して悪い方向に外す場合や、誤りが強く相関している場合は、単純に数を増やしても改善するとは限りません。同じ学習データや設計思想から来たモデルを並べると、この相関は起きやすくなります。(ここでの「正解」は厳密な真理というより、人手ラベルや仕様オーナーの判断を正解近似として置いた場合の話です)
また、多数決自体にも少数派が拾った重要なサインがかき消されるという弱点があります。単一judgeの弱点を実測したうえで、独立性を担保したjuryにコストを払うかを判断するのが良さそうです。
judge判定の用途と、人間確認に戻す境界を決める
ここでは、judge判定を自動ゲートに使ってよいのか、人間確認に戻すべきなのかを判断する方法を整理します。
メタの確信度を信用できない理由
judgeに確信度を自己申告させて、その数値を信頼の根拠に使えないか、と考えたくなるかもしれません。判定に必要なもので見たように、判定に必要な情報が欠けていたり曖昧だったりするとき、judgeは足りない情報のまま判定を下しますが、自己申告の確信度も同じ入力・同じ推論過程から生成されます。実際に、LLMが言語化した確信度は過信に偏りやすいという実測報告もあります(「Can LLMs Express Their Uncertainty?」、ICLR 2024、https://arxiv.org/abs/2306.13063)。
判定を出す過程に無かった情報を、確信度の申告だけが後から手に入れるわけではありません。つまり情報の欠落や曖昧さは確信度の申告にも同じように効き、判定が間違っているときに確信度も同じ方向に外れることがあります。したがって、少なくとも自己申告の確信度だけを、自動ゲートの信頼根拠にするのは危険です。
これは判定(task)そのものではなく、判定にどれだけ自信を持っているかというtaskの一段上のmeta taskであって、judgeを全知全能として扱わない以上、このmeta taskの申告も判定の裏取りとしては信頼しきれません。
複数回サンプリングした判定同士の一致度は判定の揺れを見る補助指標にはなりますが、同じ誤りを安定して返す場合もあるため、最終的な判断は人手ラベルとの一致で見ます。
また、収束の設計で揺れを減らしても、判定の傾向自体が人間とズレていれば一致度は低いままです。ここで測りたいのは揺れそのものではなく、人間の判断との一致度です。
人手ラベルとの一致度を測る
judge判定を自動ゲートに使ってよいかを考えるために、まずjudgeの判定と人手ラベルの一致を見ます。pass/failのような二値判定であれば、判定単位ごとにjudgeの判定と人手ラベルを4つの箱へ仕分けた混同行列を作り、偶然の一致を差し引いて見るCohen's κ(コーエンのカッパ)などが使えます。
ただ、一致度が高ければ自動化してよいというわけでもなく、誤判定コスト、caseの重要度、人間確認に戻したときの負荷も合わせて判断します。一致度指標は性能を誇示するための数字ではなく、どの判定単位なら自動ゲートに寄せられそうで、どの判定単位は人間確認に戻すべきかを判断するための材料というイメージです。
ただし、pass/failの分布が極端に偏っている場合、accuracyが高くてもκが低く見えることがあります。これは統計学における「high agreement / low kappa のパラドックス」として知られています。そのため実務では、κだけを見ず、混同行列そのもの、つまりどちら向きに外しているかや、failを検出対象としたprecision、recall、F値も合わせて確認します。
rubricはjudgeに渡す採点表であると同時に、人間がラベルを付けるための判断基準でもあります。judge用のrubricと人間側の判断基準がズレると、一致度の低さはjudge単体の問題ではなく、基準の二重化を反映している可能性があります。
また、人手ラベルも固定された真理ではありません。期待する振る舞いや重要度、解消扱いにしてよい条件は、見る人の専門性・文脈・時期・仕様理解によって揺れます。judge判定をどこまで使ってよいかを人手ラベルとの一致で判断する以上、人手ラベル側も設計対象で、誰が・どの基準で・いつ確認したかを残さないと、judgeの信頼性を測っているつもりで人間側の判断の揺れを測っているだけになりかねません。だからこそ判断理由(decision_reason)を蓄積し、類似caseの過去の判断と矛盾していないかを後から確認できるようにしておく、というような工夫が必要になります。
実運用に近づける評価フローを考える
ここまでで、判定の材料と基準、判定単位、判定の収束、judge判定の用途を整理してきました。整理すると、judge判定をそのまま使えそうな判定単位と、人間確認に戻すべき判定単位が分かれてきます。ここからは、これを実際の開発フローにどう載せるかを考えます。
ただし、人間確認に戻すといっても、誰かが目視するだけでは足りません。期待挙動、重要度、解消扱い、仕様意図は仕様オーナーが確認し、評価実装者はそれを評価ケース、rubric、fixture、runnerに落とします。その判断と実装の確認結果は、human_review_resultなどのreview履歴として残しておくと後から追えます。
以下では、期待挙動、重要度、解消条件、仕様意図に責任を持つ人を「仕様オーナー」と呼びます(チームによってはPM、プロダクトオーナー、CS責任者などが担います)。
評価フローで必要なのは、職種名ではなく、そのcaseで「どう振る舞うべきか」「どこまでを解消扱いにするか」を判断できる責任主体を明確にすることです。
次は、この整理を実際の運用へ接続する形を考えます。具体的には、違和感や苦情を個別ケースとして残し、期待挙動を確定し、CI上の評価runに載せ、必要に応じて人間確認へ戻せる状態を目指します。
実運用に近づける場合の評価フロー
評価ケースは、例えば次のような流れで扱います。
- 違和感や苦情を、個別ケースとして起票する
- 起票者は、問い合わせID、対象機能、問題の概要、実際の応答、関連する画面やログを残します。
- CSは、ユーザーの困りごと、問い合わせ文脈、再発した場合の影響を補足します。
- 仕様オーナーは、重要度、仕様意図、期待挙動メモ、解消扱いに必要な条件を確認します。
- 期待する振る舞いが最初から確定していなくてもよく、評価ケース化の段階で仕様オーナーと評価実装者がすり合わせます。
- 評価実装者が、個別ケースを評価ケースとして実装する
- 評価ケースには、case_id、input、確定したexpected behavior、rubricを定義します。
- expected behaviorは、起票時の期待挙動メモをもとに、仕様オーナーと評価実装者がすり合わせて確定します。
- 状態再現が必要な場合は、テスト用データのseed、mock data、会話履歴、画面状態など、必要な前提条件を実装します。
- case、expected behavior、fixture、rubricはversionを持たせ、変更をPRや差分で追えるようにします。
- CI runnerで、現在のcommitに対して評価runを実行する
- runnerは、前提条件を準備し、評価対象のシステム(SUT)を実行し、出力に対して決定論チェックやjudge判定を行います。
- 評価runには、commit_sha、評価ケース側のversion、judge側のversion、SUT output、judge_result、gate_resultを紐づけます。
- 本番で見つかった失敗も、個別ケースとして起票し、CI上で再現できる評価ケースにします。
以降のゲートは、同じ評価runに対して見ます。ただし、すべてのPRを一律に止めるものではありません。新規caseやrubric変更はPR上の確認対象にし、確認済みcaseの明確な回帰はCI failにし、仕様判断が必要なものはrelease approvalで止める、というように、止める段階はcaseの重要度と誤判定コストで分けます。
人間確認ゲートで確認する
- 対象
- 新規case、新しい判定単位や新しい判定形式、rubric変更後のcase、一定期間確認されていないcase、judgeの人手ラベルとの一致度が十分でない判定単位を含むcase、解消扱いにしてよいか判断が必要なcase
- case、expected behavior、rubric、fixture、judge設定のいずれかが変わったcaseも、単純な回帰として扱わず、ここに戻します
- 全件確認するとは限らず、重要度の高いcase、変更した評価観点に関係するcase、過去に判断が割れたcaseを優先して確認します
- 確認の分担
- 仕様オーナーは、期待挙動、重要度、解消条件、仕様意図とのズレを確認します
- 評価実装者は、前提条件の再現、rubric、runnerでの実行、judge判定の扱いを確認します
- 結果の記録
- review_owner、human_review_result、reviewed_atとして残します。必要に応じて、decision_reason、assumption、recheck_conditionも残します
- 結論だけでなく判断理由を残すことも有効です。
expected behaviorやhuman_review_resultだけでは、後から見た人が、なぜその振る舞いを正しいとしたのかを追えません。decision_reason、assumption、recheck_conditionのように、判断理由、前提、再確認条件を短く残すことで、仕様変更時の再確認や類似caseの判断に使えます。これは仕様オーナーの負担を増やすためではなく、人間側の判断の揺れや属人化をできるだけ抑え、判断が矛盾したときに後から検証できるようにするための工夫です
- 人間側の認識が引っ張られるリスク
- LLMがもっともらしい判定理由を出すと、レビューする側がその説明を前提にしてしまい、expected behavior、rubric、output、参照情報を独立に確認しないまま追認してしまう可能性があります
- そのため、全件で行うのではなく、重要度の高いcase、過去に判断が割れたcase、judge判定と人手ラベルが不一致だったcaseなどに絞って、最初からLLMの判定結果や判定理由を見せず、人間が一度判断してから差分を確認する運用も考えられます
- 対象
回帰ゲートで確認する
- 対象は、同じ評価条件で確認済みの評価ケースです。
- 同じcase、expected behavior、rubric、fixture、judge設定のもとで、以前passしていたcaseがfailした場合は、回帰として扱います。
- 評価条件のいずれかが変わった場合は、単純な回帰として扱わず、人間確認ゲートに戻します。
- 技術的な問題であれば評価実装者に回し、期待挙動や解消扱いの判断が必要であれば仕様オーナー確認に回します。
- 評価結果を本番化前の判断に接続する
- 本番化前には、未確認・要確認・回帰が残っていないかを見ます。
- run履歴には、run_id、commit_sha、評価ケース側のversion(case_version、expected_behavior_version、rubric_version、fixture_versionなど)、judge側のversion(prompt、model、judge_config、output_schemaなど)、SUT output、judge_result、gate_result、人間確認の結果(review_owner、human_review_result、decision_reason、reviewed_atなど)を紐づけます。
さらに、判断理由や前提を構造化して残しておくことは、将来的にAI agentに評価ケース作成、rubric更新、類似case確認を支援させるための土台にもなります。agentに最終判断を丸投げするためではなく、agentが人間の判断基準を誤って推測しないようにするためにも、判断コンテキストを評価資産として残す意味があります。
この流れで、個別ケースの起票から本番化前の判断までが一続きにつながります。
小さな例: 料金プランの誤案内を評価ケースにする場合
たとえば、ユーザーがAプランで使える機能を質問したのに、LLMがBプランの機能を混ぜて回答したcaseを考えます。この場合、評価ケースとして残す内容は次のようになります。
| 項目 | 残す内容の例 |
|---|---|
| 起票内容 | Aプランについて質問されたが、回答にBプラン専用の機能が含まれていた |
input |
ユーザーの質問、参照したプラン情報、必要なら会話履歴 |
expected behavior |
Aプランに含まれる機能だけを回答し、Bプラン専用の機能を混ぜない |
rubric |
回答に、Aプランに含まれない機能が含まれていればfail |
decision_reason |
料金プランの誤案内は契約判断に直結するため、別プランの機能混入は解消が必要な誤りとして扱う |
recheck_condition |
料金プランや機能提供範囲が変更されたとき |
| 人間確認ゲート | 仕様オーナーが、期待挙動と解消扱いにしてよい条件を確認する |
| 回帰ゲート | 同じ条件で以前passしていたcaseがfailした場合、回帰として扱う |
このように書き出してみると、「誤案内があった」という苦情が、次の評価runで再確認できる形に変わることがわかります。
また、version変更時にはpass/failだけでは変化を拾いきれないことがあります。トーン、簡潔さ、自然さ、顧客体験上の印象のように絶対的な合否線を引きにくい評価観点では、旧versionと新versionの出力を並べて比較する(pairwise)のが有効です。今回の整理では、pairwiseを自動ゲートそのものとしては扱わず、仕様オーナーが相対的な変化を確認するための材料として使うのが良さそうです。
本番後の違和感を、評価ケースへ戻す
前節の評価フローは、本番化前に評価runを実行し、人間確認ゲートと回帰ゲートで判断する流れでした。ただし、LLMアプリケーションの失敗は、本番化前にすべて見つけられるわけではありません。
CSの違和感やユーザー苦情、本番ログで見つかった失敗は、本番後のフィードバックとして評価ケースへ戻し、仕様オーナーが期待挙動や解消条件を確認できるようにしておく、というような運用が考えられます。
ここで扱うべきなのは、苦情をその場で処理して閉じることではなく、再発防止の評価資産に変換することです。本番後に見つかった失敗は、既存caseの更新、新規caseの追加、rubricの見直し、期待挙動の再確認のいずれかとして評価資産へ戻します。
解消扱いの判断も、judgeのpass/failだけでは閉じません。judgeの人手ラベルとの一致度が十分でない判定単位や、期待挙動そのものに判断が必要なケースでは、人間確認ゲートで解消扱いを確定します。
この流れにより、本番後に見つかった失敗も、次の評価runで再確認できる形になります。
人間が持ち続ける介入点
ここで決めたいのは、機械の判定をどこまで使い、どこから人間確認に戻すかの境界です。
「人間が確認する」とだけ決めても運用では動かないので、どの場面でjudge判定を使い、どの場面で人間確認に戻すのかを、具体的な判断点として並べてみます。
| 場面 | 人間が決めること | 機械が出す材料 |
|---|---|---|
| 個別ケースの起票 | 何を問題として扱うか、重要度をどう置くか | 問い合わせ情報、類似ケース、関連ログ |
| 期待挙動の確定 | 起票時の期待挙動メモを、評価可能なexpected behaviorとして確定してよいか | 起票内容、実際の応答、関連仕様、過去case |
| 評価ケース化 | expected behaviorとrubricが、起票内容と仕様意図を正しく表しているか | case差分、rubric案、fixture案 |
| 自動ゲートに載せてよいかの判断 | その判定単位を自動ゲートに近づけてよいか | 人手ラベルとの一致度、混同行列、過去run |
| 人間確認ゲート | どのcaseを未確認のまま通さないか | 新規case、変更case、一定期間未確認caseの一覧 |
| 回帰ゲートfail時 | 実装劣化か、仕様意図の変更か、評価側の不整合か | fail差分、SUT output、judge理由、関連PR |
| version変更時の再確認 | 評価条件の変更を単純な回帰として扱ってよいか、再確認が必要か | case/rubric/fixture/judge設定の差分、旧version/新versionの出力比較 |
| 解消判断 | 苦情や違和感を解消扱いにしてよいか | judge結果、evidence、review履歴 |
| 本番化前判断 | 未確認・要確認・回帰を残して進めるか | gate_result、review_owner、reviewed_at |
機械が出すのは、この表の右列にあたる材料までです。その材料をどう解釈し、どこまでを信じるかは、人間の側に残ります。
この一覧は固定のものではありません。運用が進めば確認すべき場面は増え、境界も動くかと思われます。それでも、意味の判断・リスク許容・仕様意図に関わる判断は、自動化が進んで部分的に任せられるようになっても、完全に機械へ移すことには難しさがあると思います。
扱っていない範囲と、この先の拡張方向
ここまで書いた評価フローは、完成した評価基盤の報告ではなく、実運用に近づける場合の構想です。実際に運用するには、十分な人手ラベル、CSの起票運用、仕様オーナーによる確認、review_ownerの設計、確認負荷の調整が必要になります。
また、何を正しい振る舞いとみなすか、どこまでを解消扱いにするかは、仕様変更、顧客層、入力分布、model version、業務運用の変化によっても変わっていきます。そのため、一度作った評価ケースやrubricで将来の振る舞いまで保証できるわけではなく、確認済みcaseでも再確認が必要になることがあります。
そのため、評価基盤は作って終わりではなく、継続的に保守・改善する対象です。LLM-as-a-Judgeによる評価は、泥臭い確認作業をなくすものではなく、その確認作業を評価資産として蓄積し、judge判定の使いどころを保ち続けるための仕組みです。
状態再現が必要なcaseでは、前提条件の実装コストもかかります。テスト用データ、mock data、会話履歴、画面状態などをどこまで再現するかは、評価したいリスクと運用コストのバランスで決めることになります。
また、実際に運用へ載せる段階では、今回扱っていないコストやレイテンシ、監視SLOといった詳細設計にも踏み込むことになります。
もちろん、評価ケースが数百、数千と増えていけば、人間確認ゲートの認知負荷、rubricの肥大化、評価観点同士の干渉、評価器そのものをどう評価するかといった、さらに上位の課題に直面するはずです。すべてのcaseを人間が同じ粒度で確認し続けることは現実的ではなく、どのcaseをサンプリングし、どの判定単位を重点的に見るか、どこから自動化を進めるかといった設計も考えられます。
ただし、そうしたスケール時の運用に進むためにも、まずは足元の失敗を言語化し、評価ケースとして資産化し、人間とLLMの境界線をすり合わせる必要があります。今回整理したような評価ケース化、人間確認ゲート、回帰ゲートの設計は、より大きな評価運用へ進むための出発点にはなると考えています。
おわりに
今回整理してみて、LLM-as-a-Judgeを運用するために必要な仕組みは、評価を完全自動化するためのものではなく、どこまでを機械に任せ、どこから人間が引き受けるかを決めるためのものだと感じました。
judgeを呼ぶこと自体は難しくありません。難しいのは、何を同じ基準で判定するか、どの単位で人手ラベルとの一致度を測るか、どのcaseを人間確認へ戻すか、どの回帰を本番化前に止めるかです。
起票から人間確認ゲート・回帰ゲートまでを一つの流れとして設計することで、judgeの判定だけでなく、人間側の期待挙動、解消判断、判断理由も評価基盤に載ります。ここまでできて、LLM-as-a-Judgeは単なる採点器ではなく、運用上の判断を支える評価基盤に近づくのだと思います。
人間の役割は、judgeを使うかどうかを一度決めることではなく、どの判定単位を自動判定に寄せ、どのcaseを人間確認へ戻し、どの回帰を本番化前に止めるかという境界を引き続けることにあります。
また、整理してみて、評価ケースのfixtureや状態再現、CI接続など、この仕組みはアプリケーション本体とかなり密結合になるという印象を受けました。runnerやrun履歴のような層は汎用化して切り出せそうな一方、状態再現やケースの中身はアプリと切り離せなさそうなので、アプリ側をどう評価しやすく設計するかを考えても面白そうだなあと思いました。
間違っている内容などありましたら、ご指摘お願いします。
最後までお付き合いいただきありがとうございます! 弊社ではエンジニアを募集しております。 ご興味がありましたらカジュアル面談も可能ですので、下記リンクより是非ご応募ください!
参考資料
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- A Survey on LLM-as-a-Judge
- LLM Evaluators Recognize and Favor Their Own Generations
- Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs
- Your AI Product Needs Evals
- Cohen's kappa(Wikipedia)
- High agreement but low kappa: I. The problems of two paradoxes
